Reliability
上周那一串大故障,提醒你发布前先查一遍依赖
11 月 12 日到 17 日这一周,海外的大服务几乎轮流出事:Microsoft 365 的 Outlook 和 Teams 挂了将近一天,Claude 两次大面积报错,AWS us-east-1 出了三个多小时的认证和连接问题,Apple 的 iCloud、Apple Pay、App Store 又因为一次内部更新瘫了几个小时。再算上美国 FAA 全国停飞、Workday、大通银行和美联航,Fortune 的报道提到,Downdetector 在截至 11 月 17 日的七天里收到 640 万条美国用户的故障报告,大约是平常一周的四倍。Downdetector 母公司 Ookla 的 Mark Giles 认为这多半是巧合,目前也没有任何公开证据说明这些故障之间有关联。
所以这篇不打算讨论「云服务靠不住」这种大问题。我想聊的是一件没上新闻、但上周确实落在很多小产品头上的事:你的产品本身没出 bug,只是它依赖的某个服务倒了,于是它也跟着倒了,或者半死不活。如果你下周要发布,值得花一个下午处理一下。
对独立开发者来说,上周真正出事的是哪几处
如果你做的是用 AI 写出来的 Web 应用,下面三件事跟你关系最大。以下时间都已换算成北京时间。
11 月 13 日周五,Anthropic 状态页记录了一次影响 claude.ai、Claude API 和 Claude Code 的大面积报错,从晚上 21:09 持续到 23:38(事故页面)。同一天傍晚 17:58 到 19:58 还有另一起事故,claude.ai 和 Claude Code 登录失败。也就是说,如果你产品的核心功能就是调一次 Claude API,那天晚上它有两个半小时基本不可用;而你平时拿来修 bug 的那个编程工具,也在同一张事故单里。走第三方中转调用的,链路上还多一环,出问题时更难判断是谁的锅。
11 月 15 日周日,AWS 在 us-east-1 报告了注册失败、认证和连接问题,北京时间大约 19:05 到 22:10,涉及 IAM Identity Center、CloudWatch、Elastic Load Balancing 等 11 项服务。这份时间线来自 Apple Scoop 根据 AWS Health Dashboard 整理的汇总。AWS 没有公布原因。
11 月 17 日(美国时间周二),Apple 多项服务因为一次内部更新中断了几个小时,CBS News 有报道。差不多同一时段,Anthropic 也记了一起事故:部分用户无法在 claude.ai 和 iOS 客户端用「通过 Apple 登录」,影响时间是北京时间 18 日凌晨 00:40 到 04:20。两件事有没有关系,Anthropic 没说。但它第一条更新里有一句话值得抄下来:「Sign in with Google and email are not affected」,也就是用 Google 和邮箱登录不受影响(事故页面)。有别的登录方式的用户,照样能进去。
这一句话,基本就是本文想说的全部。
先把依赖列出来
开一个文本文件,把用户从输入网址到看到有用内容,中间经过的每一个外部服务都写下来。一个典型的 vibe coding 项目大概是这样:域名注册商和 DNS,托管平台(Vercel、Netlify、Cloudflare),数据库和登录(很多人两样都用 Supabase),大模型 API,事务邮件,支付,统计,还有模板顺手引进来的字体或脚本 CDN。如果你面向国内用户,再加上微信登录、短信验证码、对象存储这些。
然后在每一项后面写上:它挂了,用户实际会看到什么。不是「理论上应该怎样」,是实际会怎样。写不出来的那几项,正是这个练习要找的东西。
不用每一项都去解决,也不该这么做。一个人做的产品,在发布周折腾多区域容灾,性价比很低。但有几类故障处理起来很便宜,而且恰好是最容易让上游的一次小抖动,变成发布帖下面一排「打不开了」的那几类。
让 AI 调用失败得体面一点
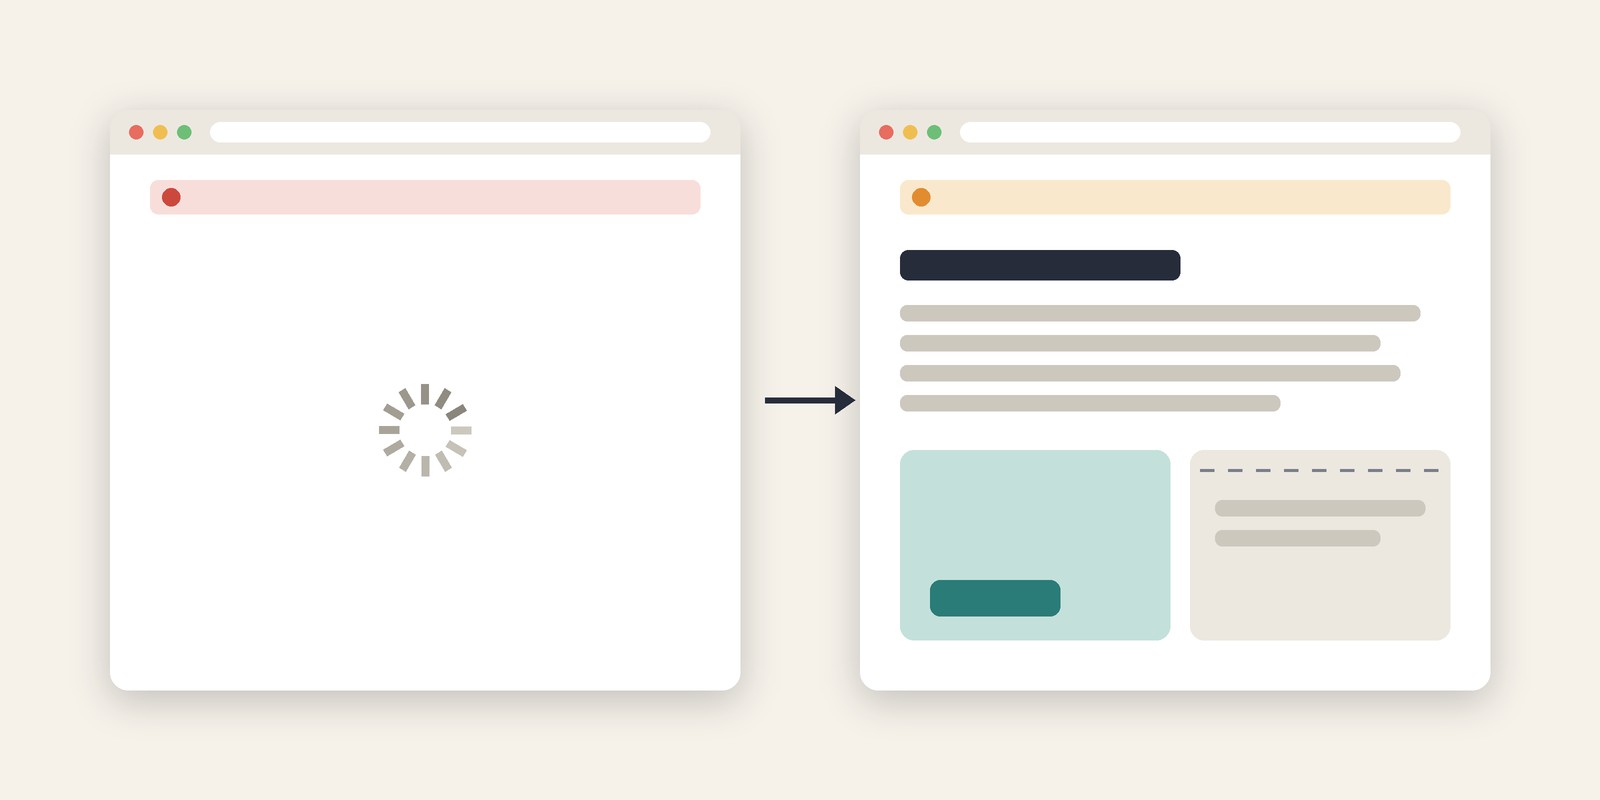
AI 生成的代码通常只写了顺利的那条路。页面调用模型,等结果,一旦报错,组件直接抛异常,用户看到的是白屏,或者一个永远转不完的加载圈。在 13 号晚上那种情况下,这个白屏就是你产品的全部。
按收益从高到低,改三处。
第一,给调用加超时。上游降级的时候往往不是马上失败,而是一直挂着,你的 serverless 函数就干等到平台把它杀掉。在路由处理函数或者任何用 fetch 的服务端代码里:
const res = await fetch(upstreamUrl, {
  method: "POST",
  headers,
  body: JSON.stringify(payload),
  signal: AbortSignal.timeout(20_000),
});
AbortSignal.timeout 是标准 Web API(MDN 文档)。如果你用的是官方 SDK,去看一下它的超时和重试参数,别默认它的缺省值适合一个有人在屏幕前等着的请求。
第二,捕获错误,返回一个你自己定义的状态码。返回 503 加一小段前端能识别的 JSON,比让未处理的异常变成一个笼统的 500 强得多。
第三,页面其他部分照常渲染。AI 那一块提示「生成服务暂时不可用,请稍后再试」就行,导航、账户页、价格页、文档都应该还能用。你可以直接这样跟编程助手说:「如果 AI 请求失败或超时,在这个组件里显示一条提示,页面其他部分保持可用。」
如果 AI 功能就是你产品的全部,至少把用户输入的内容存进 localStorage。用户辛辛苦苦写了一大段提示词,等服务恢复后不用再敲一遍。
别只留一扇门
如果你只接了「通过 Apple 登录」,或者只接了 GitHub 登录、只接了微信登录,或者只靠一家邮件服务发魔法链接,那这家服务倒霉的那个下午,也就是你倒霉的下午。在 Supabase Auth 或 Clerk 里多加一种登录方式,一般就是后台改个设置、前端多一个表单,是这篇里成本最低的一项改进。Anthropic 17 号那条事故说明了回报:坏掉的是三条路里的一条,另外两条一直能走。
找回密码也是同理。如果重置邮件只靠一家事务邮件服务发,最好提前知道邮件发不出去的时候该去哪里查。
发布前自己动手弄坏它
用不着什么混沌工程,Chrome DevTools 就够了。打开你的线上站点,进 Network 面板,右键一个发往大模型 API、数据库或登录服务的请求,选择屏蔽这个域名(DevTools 文档),然后刷新。上周五你的用户看到了什么,现在你也看到了。
把清单上的依赖挨个试一遍。重点看首页和价格页:就算整个后端都挂了,这两个页面也应该能正常打开,因为别人从你的发布帖点进来,看到的就是它们。如果你的首页是一个纯客户端渲染的应用,要先拉用户数据才肯显示内容,那数据库一出问题,你的落地页也跟着没了。
提前想好怎么说「我们知道了」
发布那周依赖的服务出问题,不吭声比故障本身更伤。你不需要专门买一个状态页产品,但有两件事要提前定好。
一是在哪里发更新。通常就是你发布用的那个 X、即刻或者小红书账号,在网站页脚放个链接。
二是一个比用户更早发现问题的检查。不管你用哪家监控服务,监控的地址都应该是一个会查数据库的接口,而不是静态首页。静态首页会一直开心地返回 200,哪怕注册功能早就挂了。最简单的健康检查接口读一行数据,成功返回 200,失败返回 503。在终端里这样看:
curl -s -o /dev/null -w "%{http_code} %{time_total}s\n" https://yourapp.com/api/health
发布当天别部署
Apple Scoop 对这一周的总结里有个观察,很适合对号入座:这些事故里至少有四起,起因是在线上系统上动了东西。Microsoft 是七月引入的一个 bug 碰上了高流量,FAA 是网络升级出了岔子,Workday 是一次灾备演练出了错,大通银行是自家硬件系统里的软件故障。隔天 Apple 又把锅算在一次内部更新上。这些都是有成熟变更流程的大公司,而你手里只有一个部署按钮和一个截止日期。
发布前一天冻结代码。如果非修不可,先搞清楚你的托管平台怎么回滚。Vercel 叫 Instant Rollback,Netlify 可以重新发布之前的某次部署。找个不忙的时候实际点一遍,免得发布帖下面已经开始有人贴报错截图了,你还在翻文档。
MySiteSure 能帮上的部分,和帮不上的部分
MySiteSure 做的是某个时间点的体检,不是可用性监控,半夜三点它不会打电话叫醒你。它会对你自己的网站从可靠性、安全、性能、SEO 和信任五个维度打分,证据来自 Lighthouse、DNS、TLS、安全响应头、页面元数据、robots.txt、sitemap.xml 等检查,每条问题都附一段可以直接贴给编程助手的修复说明。它覆盖的是陌生人从外面能看到的那一半上线准备。上面那套依赖梳理是另一半,外部扫描工具替你做不了,因为答案在你的代码里。